Откуда взялись 95%
В августе 2025 года деловые СМИ разнесли фразу «95% ИИ-пилотов проваливаются». Источник — отчёт MIT NANDA «The GenAI Divide: State of AI in Business 2025», на титуле стоит июль 2025 года. Файл помечен как версия v0.1, на второй странице написано Preliminary Findings, то есть предварительные выводы. Рецензентом указан один из соавторов, внешнего рецензирования не было. MIT отчёт больше не хостит, мы читали копию на стороннем сайте.
В резюме отчёта сказано: «Несмотря на $30–40 млрд корпоративных инвестиций в генеративный ИИ, отчёт выявляет неожиданный результат: 95% организаций получают нулевую отдачу» (MIT NANDA, 2025, копия v0.1; здесь и дальше перевод наш). Следующим предложением авторы пишут, что миллионы приносят лишь 5% интегрированных ИИ-пилотов, а подавляющее большинство застряло без измеримого эффекта на P&L. Из этих двух фраз и получились «95% проваленных пилотов». Но пилот, который не приносит миллионов, ещё не обязательно провалился.
Теперь метод. Авторы просмотрели больше 300 публично описанных ИИ-проектов, провели структурированные интервью с представителями 52 организаций и собрали 153 анкеты руководителей на четырёх отраслевых конференциях. Период — январь–июнь 2025 года.
Успешным считался инструмент под конкретную задачу, про который пользователи или руководители сказали, что он дал заметный и устойчивый эффект на производительность или P&L. Сказали, а не показали в отчётности. Авторы сами оговаривают: цифры верны по направлению, опираются на интервью, а не на официальную отчётность компаний, и определения успеха у разных организаций могут не совпадать.
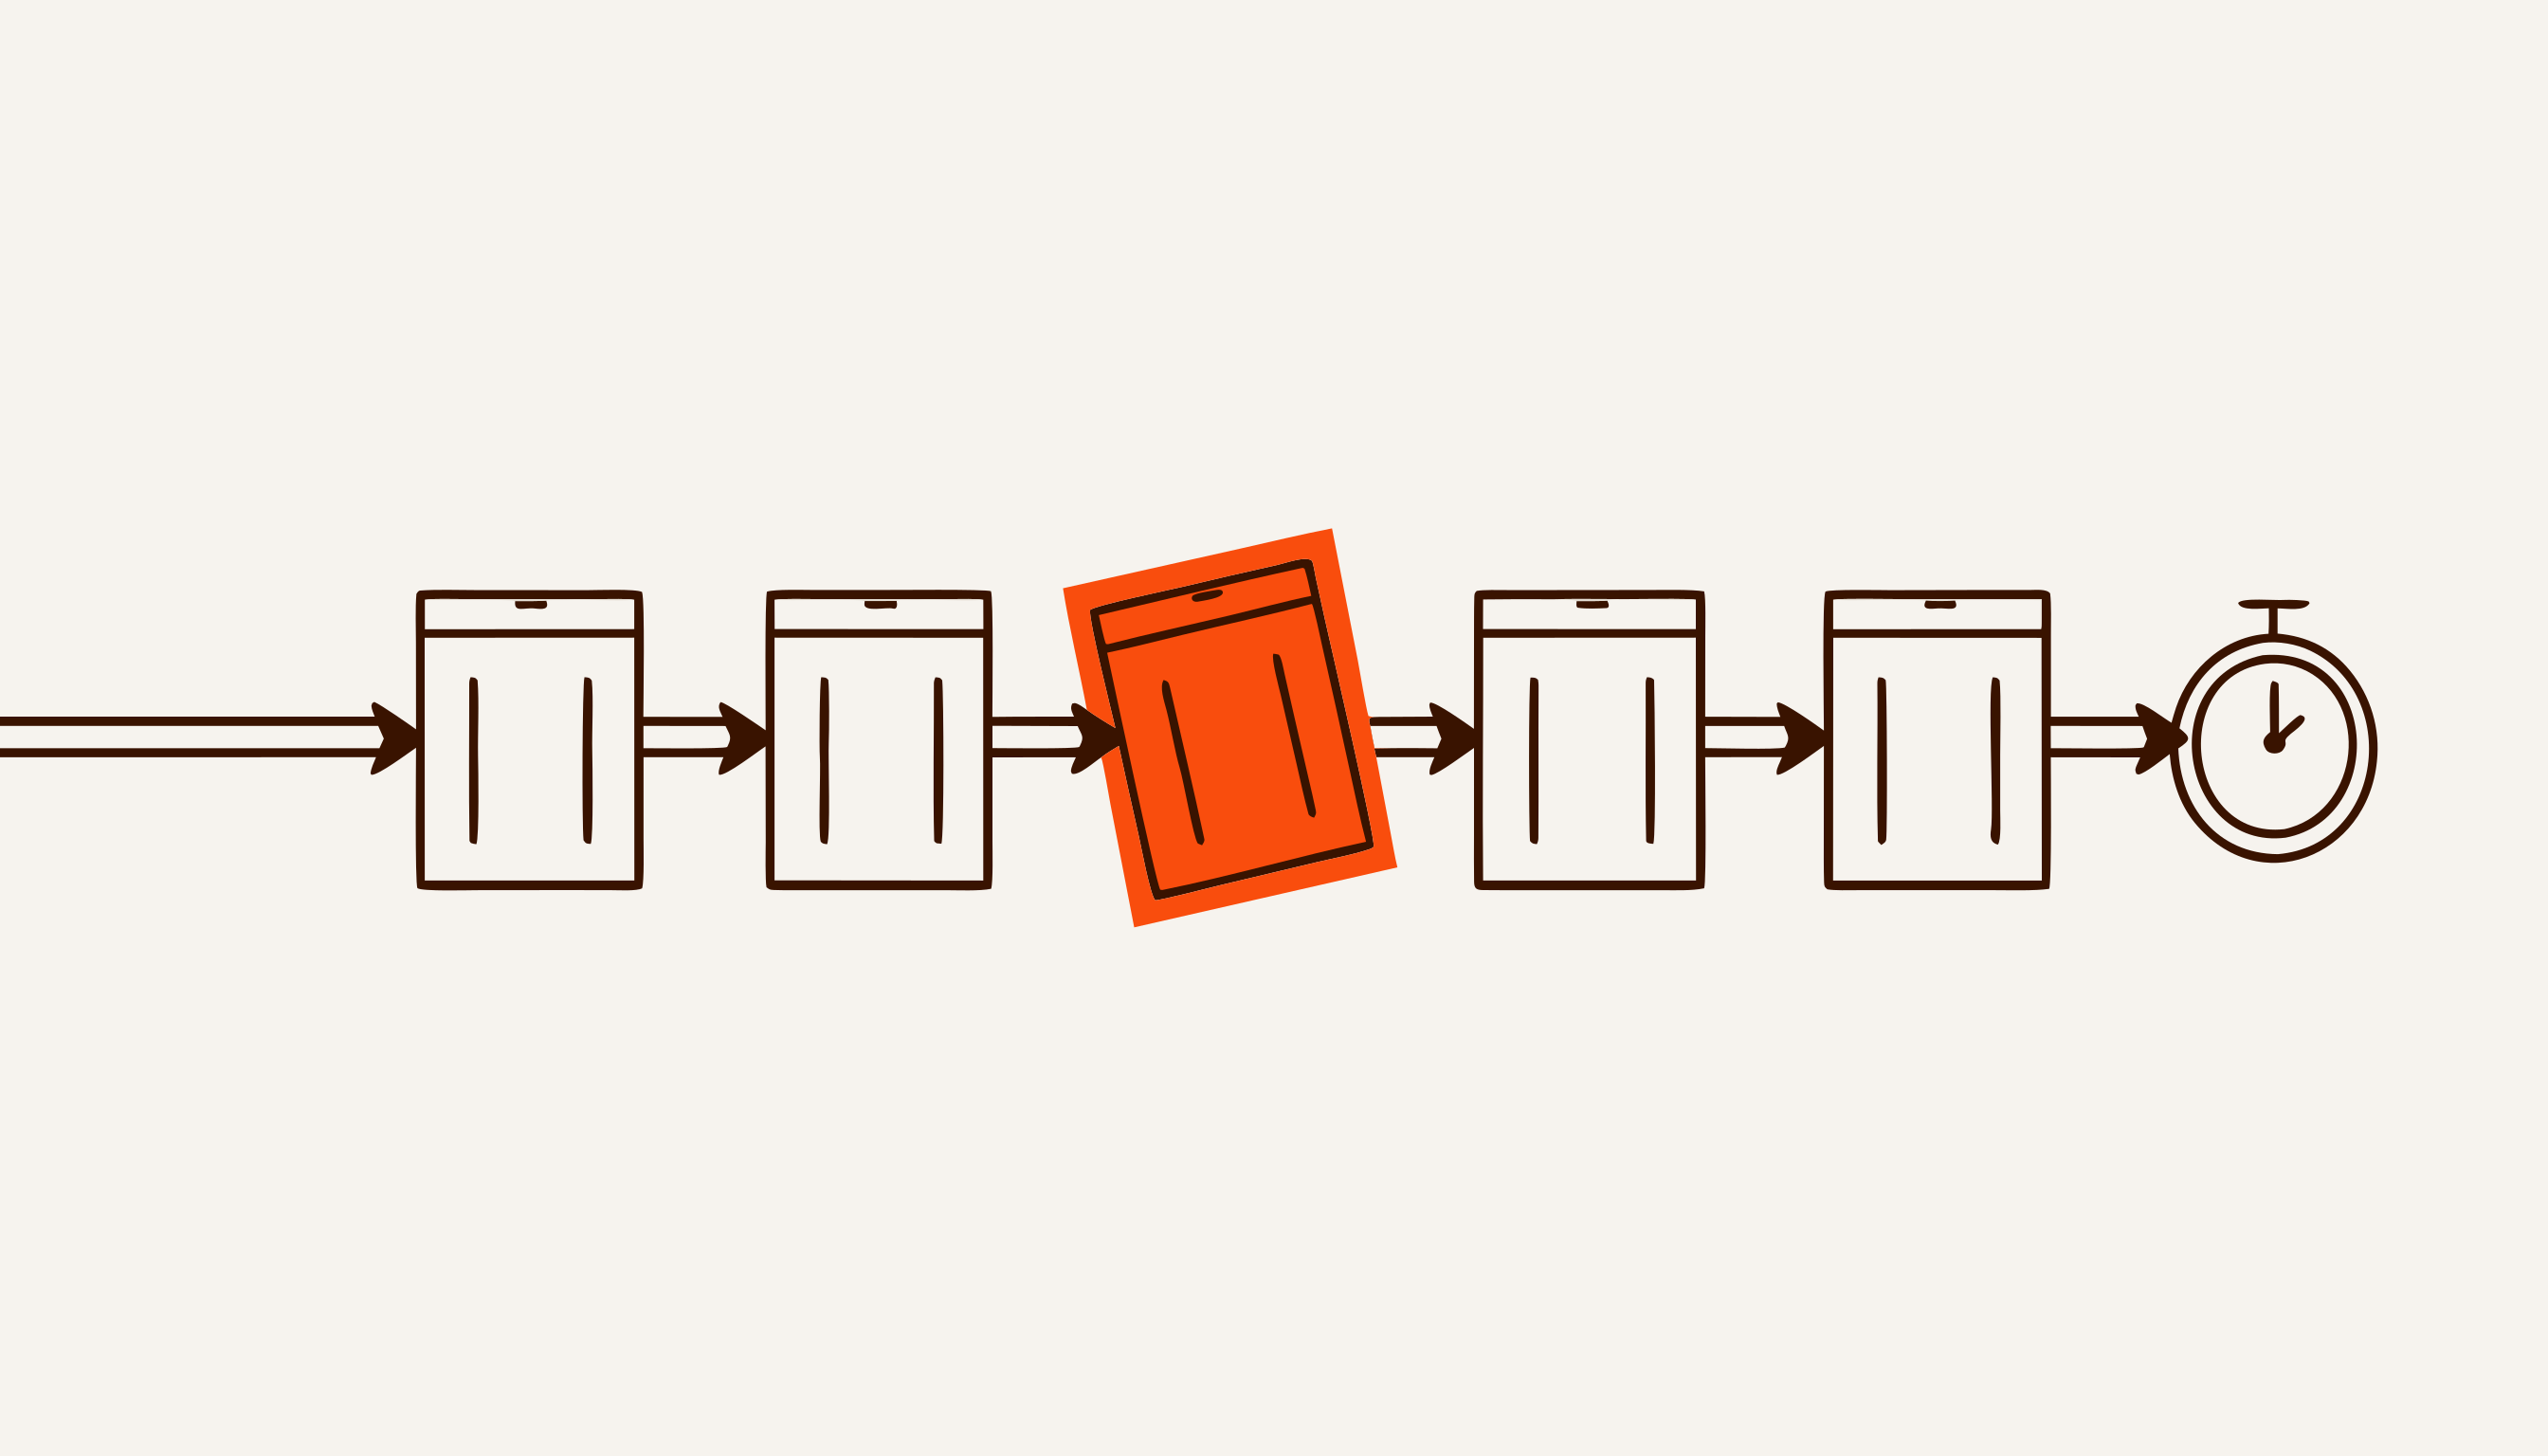
В отчёте есть и второе число — про корпоративные ИИ-системы, заказные или купленные у вендора. Их изучали 60% организаций, до пилота дошли 20%, до продакшена — 5%. Это другое утверждение, и касается оно только таких систем: ChatGPT и Copilot в него не входят. Если читать воронку так, как она нарисована, из организаций с пилотом в продакшен вышла каждая четвёртая, а не каждая двадцатая.
Про ChatGPT и Copilot в том же отчёте сказано, что они распространены широко: больше 80% организаций их изучали или пилотировали, почти 40% сообщают о внедрении. Официальную подписку на языковую модель купили 40% компаний, а сотрудники больше чем в 90% компаний регулярно пользуются для работы личными ИИ-инструментами. По оценке авторов, такие инструменты повышают в первую очередь личную продуктивность, а не P&L. Этот же разрыв ниже покажет опрос McKinsey.
Колл-центр: выиграли новички
Эрик Бриньолфссон, Даниэль Ли и Линдси Рэймонд изучали службу поддержки американской софтверной компании. Канал — текстовый чат. Операторам дали ассистента на базе GPT: он предлагал варианты ответа, а отвечал всё равно человек.
Метрика — решённые обращения в час. В рабочей версии NBER от апреля 2023 года на 5 179 операторах рост в среднем 14%, у новичков и низкоквалифицированных 34%, у опытных и сильных — минимальный. В версии, опубликованной в Quarterly Journal of Economics в 2025 году, выборка уточнена до 5 172 человек. Средний эффект там 15%, у менее опытных и менее квалифицированных около 30%. У самых сильных — небольшой прирост скорости и небольшое снижение качества. Кроме того, клиенты стали писать в чат доброжелательнее, а операторы реже увольнялись.
Авторы объясняют это так: инструмент передаёт новичкам приёмы лучших операторов. Опытным, судя по цифрам, передавать было почти нечего: они и так работали этими приёмами.
Для пилота отсюда следует простая вещь. Средние 15% складываются из заметного роста у одних и почти нулевого у других. Если считать только среднее, не видно, кому инструмент нужен, а кому мешает.
BCG: граница, за которой ИИ вредит
В 2023 году исследователи из HBS, Wharton и MIT Sloan вместе с BCG провели эксперимент на 758 консультантах — около 7% рядовых консультантов фирмы. Дизайн зарегистрировали заранее. Инструмент — GPT-4.
На 18 задачах, которые укладывались в возможности модели, консультанты с ИИ выполнили на 12,2% больше задач, работали на 25,1% быстрее, а качество было выше больше чем на 40%. Те, кто до эксперимента показывал результат ниже среднего, прибавили 43%, выше среднего — 17%. Эту часть обычно и пересказывают.
Одну задачу авторы специально выбрали за пределами возможностей модели. На ней консультанты с ИИ «на 19 процентных пунктов реже приходили к правильному решению, чем без ИИ» (HBS Working Paper 24-013, 2023). В названии работы эта граница так и описана — зазубренная, то есть неровная.
У исследования два ограничения. Задачи похожи на консалтинговые, но составлены специально для эксперимента. Модель — GPT-4 образца 2023 года. По словам одного из авторов, статья вышла в Organization Science в 2026 году, но финальный текст мы не читали и ссылаемся на рабочую версию.
METR: медленнее в 2025-м, неясно в 2026-м
В июле 2025 года METR опубликовала рандомизированный эксперимент: 16 опытных разработчиков крупных open-source-проектов, 246 реальных задач, Cursor Pro с Claude 3.5 и 3.7 Sonnet. До начала разработчики ждали ускорения на 24%. После считали, что стали быстрее на 20%. По замеру задачи с ИИ заняли на 19% больше времени.
METR сразу оговорила, что это снимок начала 2025 года в одних условиях, а не доказательство, что ИИ бесполезен большинству разработчиков.
В феврале 2026 года вышло обновление по инструментам конца 2025-го. У исходной группы время на задачу −18%, то есть ускорение, но доверительный интервал от −38% до +9%. У новых участников −4%, интервал от −15% до +9%. Оба интервала включают ноль: статистически значимого эффекта нет ни в одну сторону.
Причина смены дизайна интереснее самих цифр. Участникам платят $50 в час, и всё равно растёт доля разработчиков, которые не хотят делать половину работы без ИИ. Из выборки выпадают те, кто охотнее всего работает с ИИ, поэтому, по оценке METR, настоящее ускорение может быть заметно выше замеренного. «Из-за серьёзности этих эффектов отбора мы работаем над изменениями в дизайне исследования», — пишет METR (февраль 2026). На странице исследования 2025 года теперь стоит пометка, что те результаты больше не отражают текущий эффект.
Кто в 2026 году цитирует «на 19% медленнее» без этого обновления, пересказывает устаревший замер.
Разрыв, который описал Солоу
25 августа 2026 года The Register пересказал новый опрос McKinsey «The state of AI in 2026: On the road to ROI». Опрошено 1 719 человек. Восемь из десяти говорят, что ИИ повысил их личную продуктивность. Хоть какой-то эффект ИИ на EBIT видят 37%, примерно столько же, сколько годом раньше. Тех, кто относит к ИИ не меньше 5% EBIT и называет эффект значительным, около 6%.
Оба числа — ответы респондентов, а не данные из отчётности компаний. Но спрашивали про разное: 80% — про собственную работу, 37% — про прибыль компании. Первое во второе само не переходит.
Разрыв старый. В 1987 году экономист Роберт Солоу написал в рецензии для New York Times Book Review: «Компьютерный век виден повсюду, кроме статистики производительности» (по сводке Йорама Баумана). С этой фразы обычно начинают разговор о парадоксе производительности. Через 39 лет её можно переписать почти без правок: рост продуктивности чувствуют восемь из десяти, а в EBIT его видят 37%.
Что мерить в своём пилоте
Три эксперимента выше отличаются от отчёта MIT одним: в них результат замеряли, а MIT его спрашивал. Для пилота на один процесс это переводится в шесть правил.
- Записать метрику до старта. В науке это называется предварительной регистрацией, так был устроен эксперимент BCG: гипотеза и способ замера фиксируются раньше, чем появились данные. В пилоте хватит одного предложения — что считаем, в каких единицах, какое число будет успехом.
- Замерить «до». Неделю работать как обычно и считать то же самое. Если поток позволяет, лучше контрольная группа: часть обращений идёт по-старому.
- Считать новичков и опытных отдельно. Среднее прячет, у кого случился рост.
- Мерить качество вместе со скоростью. За границей возможностей модели консультанты BCG ошибались чаще, а у сильнейших операторов колл-центра качество немного просело.
- Засекать, а не спрашивать. Разработчики METR были уверены, что ускорились, замер показал замедление.
- Переводить в деньги. Рост личной продуктивности отмечают 80% опрошенных McKinsey, эффект на EBIT — 37%. Пилот должен отвечать на второй вопрос.
Как выбрать сам процесс для такого пилота, мы разбирали в статье о том, что автоматизировать первым.
Наши пилоты идут две недели, и метрику успеха мы записываем до начала работы. По сути это та же предварительная регистрация, только масштаб — один процесс. Результатов собственных пилотов у нас пока нет, поэтому в статье нет ни одной нашей цифры.
Чего мы не знаем
Отчёт MIT NANDA — версия v0.1 с пометкой Preliminary Findings, без внешнего рецензирования. MIT его больше не хостит, мы читали копию на стороннем сайте. Страница McKinsey у нас не открылась: цифры взяты из пересказа The Register, даты опроса и точные формулировки мы не сверили. Финальную версию статьи BCG в Organization Science мы не видели. Цитату Солоу приводим по сводке Баумана, архив New York Times не открывали.
Колл-центр — одна компания и один тип задач. Эксперимент BCG шёл на задачах, составленных для исследования, и на модели 2023 года. Ни одно из этих исследований не проводилось на малом бизнесе Узбекистана или ОАЭ, и переносить их проценты на ваш процесс напрямую нельзя.
Как мы строим такие пилоты — один процесс на старте и метрика «до» в договоре, — описано на странице «Внедрение ИИ в бизнес».
Если хотите, чтобы процесс для такого пилота разобрал кто-то со стороны, опишите его в анкете на главной. Разбор одного процесса придёт за 48 часов, бесплатно и без звонка.